Du skifter model-ID fra claude-fable-5-1 til claude-fable-5-2, og listeprisen falder med 20 procent. Har du skruet modellen op på max, bliver regningen alligevel cirka dobbelt så stor. Det viser de første uafhængige målinger af Claude Fable 5.2, som Anthropic udgav mandag 9. november.
Forklaringen ligger i tokenforbruget. Artificial Analysis har kørt sit testbatteri, Intelligence Index, på modellen ved flere effort-niveauer. På max bruger Fable 5.2 275 millioner output-tokens på testen mod 163 millioner for Fable 5.1, og prisen pr. opgave stiger fra 12,99 til 26,54 dollar. På high, som er standardniveauet i API'et, koster samme opgave 9,08 dollar. Det er mindre end Fable 5.1 på max, og scoren er kun tre point lavere end på max. Claude 5.2 er altså både billigere og dyrere end forgængeren. Det afhænger af én enkelt parameter.
Hvad er nyt i Claude Fable 5.2?
Fable 5.2 og Mythos 5.2 er ifølge Anthropic den samme model. Forskellen er sikkerhedsfiltrene: Fable 5.2 har filtre mod misbrug inden for cybersikkerhed og biologi og kan derfor sælges til alle. Mythos 5.2 er kun for organisationer, Anthropic har godkendt gennem sine verifikationsprogrammer. Filtrene er samtidig blevet mindre nervøse. I Anthropics tidlige test afviste Fable 5.2 omkring 55 procent færre forespørgsler end Fable 5.1, med cirka 60 procent færre afvisninger inden for cybersikkerhed og 40 procent færre inden for biologi.
De vigtigste tal fra lanceringen:
- Pris: 8 dollar pr. million input-tokens og 40 dollar pr. million output-tokens, mod 10 og 50 dollar for Fable 5.1.
- Batch-kørsel koster det halve, 4 og 20 dollar. Læsning fra cachen koster 0,20 dollar pr. million tokens.
- Svarene kommer op til 30 procent hurtigere end fra Fable 5.1. En valgfri fast mode skriver op til 2,5 gange hurtigere og koster 16 og 80 dollar.
- Kontekstvinduet er på 1 million tokens, og et svar kan være op til 128.000 tokens langt.
- Modellen tænker altid, før den svarer. Effort-parameteren styrer kun, hvor meget den tænker.
Anthropic viser også, hvad modellen kan, når den får lov at arbejde længe. Et hold på 1.000 Fable 5.2-agenter formaliserede beviset for Fermats sidste sætning på 30 timer. Med samme opsætning nåede Opus 5.5 26 procent af arbejdet på 18 timer. Ifølge Anthropic har modellen også designet tre fungerende elektroniske apparater fra bunden og løst to åbne problemer om sorte huller.
Hvor meget bedre er Fable 5.2 end Opus 5.5?
Mod Opus 5.5, som Anthropic selv kalder sin "strongest daily driver", vinder Fable 5.2 på næsten alle Anthropics egne målinger. Forspringet er størst i opgaver, hvor modellen skal arbejde selvstændigt i lang tid, og mindst i almindeligt kontorarbejde.
| Test | Hvad den måler | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0 | Svære kodeopgaver | 49,1 % (xhigh) | 45,5 % (max) |
| FrontierSWE v2 | Softwareudvikling | 69,9 % | 62,3 % |
| Remote Labor Index | Betalte freelanceopgaver | 41,3 % | 21,3 % |
| RoboDojo Sim | Styring af robotter i simulation | 64,9 % | 39,4 % |
| Humanity's Last Exam | Ekspertspørgsmål, med værktøjer | 74,2 % | 67,7 % |
| Chartography | Aflæsning af diagrammer | 73,4 % | 64,4 % |
| OSWorld 2.1 | Betjening af en computer | 89,3 % | 87,2 % |
| AA-Briefcase v1.1 | Kontorarbejde, Elo | 1785 | 1800 |
Alle tal i tabellen er Anthropics egne. Den største forskel ses i Remote Labor Index, hvor Fable 5.2 klarer næsten dobbelt så mange freelanceopgaver som Opus 5.5. På kontorarbejde målt i Elo ligger Opus 5.5 lidt foran. Den uafhængige måling peger samme vej: Fable 5.2 på max er nummer 1 af 74 modeller i Artificial Analysis' Intelligence Index med 65 point, mens Opus 5.5 på max får 59.
Hvad koster en opgave på hvert effort-niveau?
Effort-parameteren bestemmer, hvor længe modellen tænker, før den svarer, og den har fem trin: low, medium, high, xhigh og max. Prisen pr. token er den samme på alle fem, men antallet af tokens er det ikke. Derfor er prisen pr. løst opgave et bedre mål end prisen pr. million tokens, og her er tallene fra Artificial Analysis:
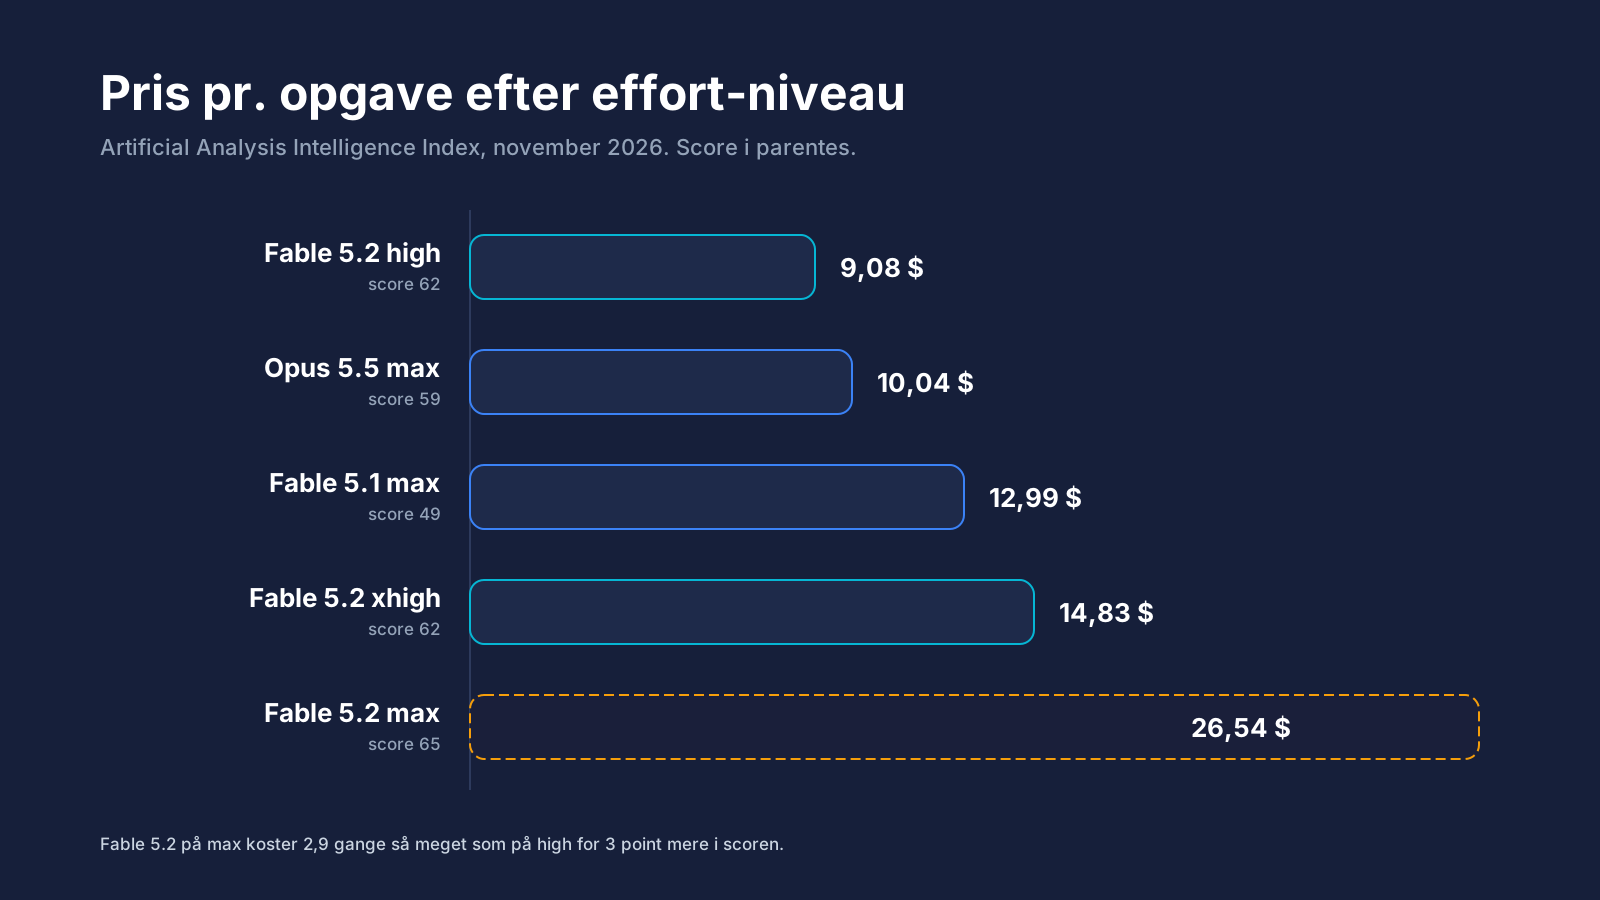
Springet fra high til xhigh giver ingen ekstra point i Intelligence Index. Begge niveauer ender på 62, men xhigh bruger 144 millioner output-tokens mod 85 millioner på high og koster 63 procent mere. Fra xhigh til max stiger scoren med tre point, og prisen bliver næsten fordoblet igen. Max-niveauet er også langsomt. Artificial Analysis målte i gennemsnit 46 minutter pr. opgave og 220 sekunder, før det første ord i svaret kom.
Anthropics egen dokumentation når frem til det samme. Start på high, for "most of the gain in capability is already present at high". Brug kun xhigh til de sværeste lange kode- og agentopgaver, og kun hvor du har målt en gevinst. Max er ifølge dokumentationen til at måle modellens loft og til "the rare task where time and tokens don't matter". Har du tidligere oplevet, at token-forbruget løber løbsk i en agent, er det her, du skal kigge først.
To ting kan hæve regningen, uden at du har bedt om det. Fable 5.2 tænker på medium og derover, også selv om din prompt beder den om at svare direkte. På high tænker den før næsten hvert eneste svar, så lette opgaver skal have et lavere effort-niveau. Modellen sender også gerne opgaver videre til underagenter, og ifølge Anthropic kan de stå for en stor del af prisen på en session.
Skal du vælge Fable 5.2 eller Opus 5.5?
Anthropic anbefaler selv, at du starter med Opus 5.5 til det meste kodearbejde og vidensarbejde og kun rykker op til Fable 5.2, når Opus 5.5 på et højt effort-niveau ikke løser opgaven godt nok. Tallene giver anbefalingen ret på max, hvor Opus 5.5 koster 10,04 dollar pr. opgave mod 26,54 dollar for Fable 5.2. På high vender billedet. Her slår Fable 5.2 Opus 5.5 på max med 62 mod 59 point og er samtidig en smule billigere. Har du læst, at Opus 5.5 når Fable-niveau for under halv pris, gælder det altså ikke længere uden forbehold.
På abonnementerne er der en grænse. På Pro og på almindelige Team-pladser må Fable bruge op til 50 procent af den ugentlige kvote, og i Claude-apps og Claude Code kører modellen som standard på medium.
Fire ændringer i API'et, der kan få din kode til at fejle
Det er ikke nok at skifte model-ID, hvis din kode selv bygger samtalen op. Anthropic nævner fire ændringer fra Fable 5.1, der kan give fejl:
- Ændrer din kode i tidligere beskeder, systemprompten eller værktøjslisten midt i en samtale og sender modellens tankeblokke med igen, svarer API'et med fejl 400 på alle konti. På Fable 5.1 gjaldt det kun konti oprettet 31. august eller senere.
- Kun Fable 5.2 og Mythos 5.2 kan læse Fable 5.2's tankeblokke. Sender en router samtalen videre til Opus 5.5 eller Fable 5.1, går modellens ræsonnement tabt.
- Det gamle værktøj til computerstyring,
computer_20251124, giver fejl alle andre steder end på Amazon Bedrock. Brugcomputer_toolset_20260801i stedet. - Bruger du advisor-værktøjet, skal rådgiveren også være Fable 5.2 eller Mythos 5.2.
Tvungen værktøjsbrug med tool_choice virker heller ikke. Har du brug for gyldig JSON, skal du bruge strict tool use eller JSON outputs. Og så kræver både Fable 5.2 og Mythos 5.2 30 dages opbevaring af data. Modellen kan ikke bruges med zero data retention, medmindre Anthropic udtrykkeligt har godkendt det. Har du en AI-integration via API, der kører med zero data retention, kan du derfor ikke bare skifte.
Bruger du Claude Code, claude.ai eller Agent SDK, behøver du ikke gøre noget ved den første ændring, for de bygger kaldene korrekt. Bygger du selv dine kald, er du også sikker, så længe koden kun tilføjer nye beskeder og sender hvert svar tilbage præcis, som API'et leverede det.
Tilbage til model-ID'et, du skiftede i første afsnit. Det, der afgør regningen i Fable 5.2, er ikke de 8 og 40 dollar på prislisten, men tallet ud for effort. Står det på high, får du en bedre og lidt billigere model end Opus 5.5 på max. Står det på max, betaler du næsten tre gange så meget for tre point mere.
Kilde: Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2