Tag en pc med en 16-kerners AMD Ryzen 9 9955HX, 64 GB DDR5 og intet grafikkort. På den maskine kører udvikleren bag llama-modchip DeepSeek V4 Flash, en model med 284 milliarder parametre, helt i RAM med plads til 256.000 tokens kontekst. Modellen skriver 9 til 15 tokens i sekundet, og hele processen fylder 57,6 GiB.
Du kan altså køre DeepSeek V4 lokalt uden GPU, hvis tallene holder. Indtil videre er de dog kun målt på udviklerens egen maskine, og prisen er en komprimering så hård, at ingen har vist, hvor meget af modellens evner der er tilbage. Projektet ligger på GitHub under Synchopate, blev oprettet 29. oktober, er udgivet under Apache 2.0 og har i skrivende stund 358 stjerner. Det er samme model, som fællesskabet for nylig fik til at køre DeepSeek V4 Flash lokalt på et grafikkort. Her er grafikkortet bare helt væk.
Fra 167 GB til 57 GB
DeepSeeks officielle V4-Flash-0731 fylder omkring 167 GB med vægte i FP4 og FP8. En almindelig 2-bit-udgave til llama.cpp i formatet IQ2_XXS fylder 76,9 GiB og løber tør for hukommelse på en maskine med 64 GB. Llama-modchip presser modellen ned på 56,6 GiB ved at behandle de forskellige dele af modellen meget forskelligt.
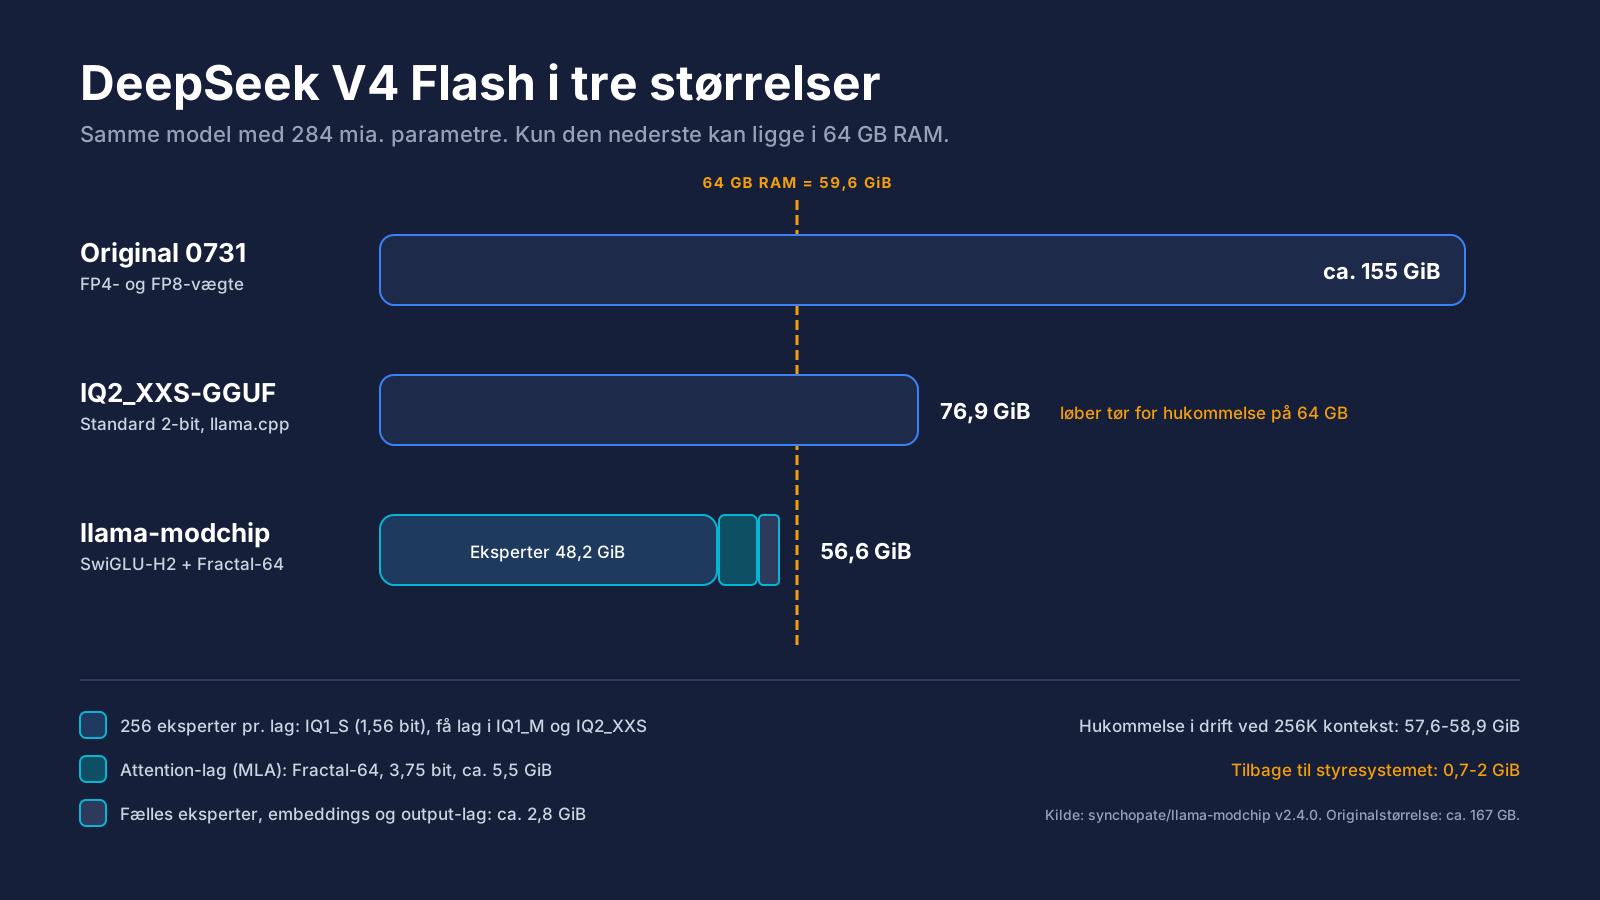
DeepSeek V4 Flash er en mixture-of-experts-model. Hvert af de 43 lag har 256 eksperter, men et ord bruger kun seks af dem plus en fælles ekspert, så kun 13 milliarder parametre er i brug ad gangen. Eksperterne udgør omkring 265 milliarder af de 284 milliarder parametre, og det er dem, llama-modchip skærer hårdest i:
- Eksperterne gemmes i IQ1_S med 1,56 bit pr. vægt. Enkelte lag, som udvikleren vurderer er følsomme, får lidt mere i IQ1_M og IQ2_XXS. Til sammen 48,2 GiB.
- Attention-lagene får projektets eget format, Fractal-64, med 3,75 bit pr. vægt. Det er omkring 5,5 GiB.
- Fælles eksperter, embeddings og output-laget fylder de sidste 2,8 GiB.
Hvilke dele af hver ekspert der skal bevares bedst, afgør metoden SwiGLU-H2 ud fra en formel, der kun ser på vægtene selv. Normalt kører man tekst gennem modellen for at se, hvilke vægte der betyder mest, men det har udvikleren sprunget over for at slippe for at køre et kalibreringssæt gennem en model på 284 milliarder parametre. Det sparer timevis af regnetid. Det betyder også, at komprimeringen aldrig har set et eneste ord.
Hvor hurtigt kører DeepSeek V4 uden grafikkort?
Ved siden af komprimeringen har projektet skrevet nye regnekerner til processoren. De bruger AVX-512 og deler arbejdet op, så data så vidt muligt bliver i processorens cache i stedet for at blive hentet fra RAM igen og igen. Det er her, hastigheden kommer fra. Alle tal herunder er udviklerens egne, målt på Ryzen 9 9955HX med 64 GB DDR5.
| Opsætning | Hardware | Læser prompt | Skriver svar |
|---|---|---|---|
| llama-modchip, standard | CPU, 64 GB | 43-44 tokens/s | 9,1-10,0 tokens/s |
| llama-modchip, færre eksperter | CPU, 64 GB | 43-44 tokens/s | 10,1-10,7 tokens/s |
| llama-modchip med Stockfish-PVS | CPU, 64 GB | 43-44 tokens/s | 11,5-14,7 tokens/s |
| Strata-DS4 | RTX 4090 og 90 GB RAM | op til 392 tokens/s | 23-24 tokens/s |
Rækken med færre eksperter bruger fire eller fem af de seks eksperter i de fleste lag. Det giver et lille hastighedsløft og en lille, målbar forskel i output. Stockfish-PVS er projektets navn for spekulativ afkodning med en lille gættemotor på 1,64 MB, der låner idéer fra skakprogrammet Stockfish. Den foreslår de næste ord ud fra mønstre i teksten, og den store model godkender dem i én omgang. Gevinsten afhænger af, hvor forudsigelig teksten er, så kode med mange gentagelser får mere ud af det end fri prosa.
Det tal, der betyder mest i praksis, er det første. Med 44 tokens i sekundet tager det knap fire minutter at læse en prompt på 10.000 tokens. Til en samtale går det. Til en kodeagent, der sender lange prompter med værktøjsbeskrivelser og filindhold, er det her, ventetiden ligger.
"Lossless" betyder noget andet her
Projektet kalder sin standardopsætning "lossless" og viser en tabel, hvor den matcher 100 procent token for token. Sammenligningen er med projektets egen komprimerede model før de seneste optimeringer, ikke med den originale DeepSeek V4 Flash. Det, der er tabsfrit, er altså de nye regnekerner. Selve komprimeringen fra omkring 167 GB til 56,6 GiB er der ingen måling af i README'en, projektets DeepSeek-dokumentation, FAQ'en eller udgivelsesnoterne.
Projektets kvalitetstest med 100 point, der tester værktøjskald, kode og at finde en detalje i en lang tekst, er kun kørt på den mindre Nemotron-model. Den scorede 100 af 100. For DeepSeek-udgaven findes der ikke noget tilsvarende.
Erfaringer fra andre giver en idé om, hvad 1-bit kan koste. Unsloth komprimerede DeepSeek V3.1 til omkring 1 bit med en metode, der bruger kalibreringsdata. På kodetesten Aider Polyglot faldt resultatet fra 70,7 procent i 5-bit til 55,7 procent i 1-bit. Det er en anden model og en anden metode, så tallet kan ikke flyttes direkte over. Men det viser, at selv en omhyggelig 1-bit-komprimering koster point, og llama-modchip springer kalibreringen over.
Den sidste gigabyte
En pc med 64 GB RAM har omkring 59,6 GiB at gøre godt med. Llama-modchip bruger 57,6 til 58,9 GiB ved fuld kontekst. Det efterlader 0,7 til 2 GiB til styresystemet, browseren og alt andet. WindowsForum kalder det en demonstration af grænsen, ikke en anbefalet opsætning, og det er en rimelig beskrivelse. Projektets eget eksempel på at starte serveren bruger i øvrigt 32.768 tokens kontekst, ikke de 256.000, overskriften lover.
Der er også krav, der ikke står i titlen:
- Processoren skal have AVX-512BW. Det har AMD Zen 4 og Zen 5 og en del Intel-processorer, men mange ældre pc'er falder fra.
- Modelfilerne bruger en ny tensortype, som almindelig llama.cpp, Ollama og LM Studio ikke kan åbne. Du skal bruge projektets egen binære fil eller dets script.
- 284B-resultatet er målt på Linux. Windows-pakken i repoet er bygget til en blanding af grafikkort og processor, og der er ingen tal for DeepSeek på Windows.
- Ingen uden for projektet har gentaget 284B-målingen. Fællesskabets resultater på projektets ranglister gælder den mindre Nemotron-model.
Claude Code på din egen maskine
Den mest praktiske del af projektet er måske kommandoen ./modchip claude. Den starter Claude Code, Anthropics kodeagent, men sender alle forespørgsler til den lokale model i stedet for Anthropics servere. Alle 40 værktøjer i Claude Code er aktive, og intet forlader maskinen. Det er samme idé som andre lokale AI-kodeagenter, bare med en langt større model bag.
Problemet er den langsomme promptlæsning. Claude Code sender en stor systemprompt og værktøjsliste med i hver tur, og på en processor tager det ifølge udvikleren omkring 45 sekunder at læse det hele igen. Llama-modchip gemmer derfor modellens mellemregninger for den faste del af prompten i hukommelsen og henter dem på 13 til 33 millisekunder, så kun det nye i hver tur skal læses. Hver ny tur med værktøjsoutput på et par hundrede tokens skal stadig igennem, men det tager sekunder i stedet for minutter.
Til AI-agenter, der skal køre i lukkede miljøer uden adgang til internettet, er det en interessant opskrift. Har du ikke 64 GB, peger projektet selv på NVIDIA Nemotron 3.5 30B, som fylder 14,4 GiB, kører i 16-32 GB RAM og skriver 25 til 60 tokens i sekundet på samme 16-kerners processor. Den er langt mindre, men den er også den eneste af de to, projektet har kvalitetstestet.
Vil du prøve DeepSeek-udgaven, så gør det med en opgave, du kender svaret på, og sammenlign med svaret fra en ukomprimeret udgave af 0731-vægtene. DeepSeeks egen API er ikke en god målestok, for siden 10. september sender den forespørgsler videre til den nyere V4.1 Flash. Hastigheden kan du måle på fem minutter. Om en model med 1,56 bit pr. ekspertvægt stadig er DeepSeek V4 Flash, er det spørgsmål, projektet endnu ikke har svaret på.