Qwen4-Max er ude af preview. Alibaba frigav sit nye flagskib til alle den 16. november, og to dage efter havde The New Stack sat Qwen 4 op mod Claude Opus 5.5 i tre agentopgaver. Resultatet er en model, der koster omkring en tredjedel af Opus, men bruger tre gange så lang tid og laver lidt flere fejl.
Samme dag kom der en anden Qwen-nyhed fra en helt anden kant. Firmaet RadixArk udgav DaisyRose-27B, en lille model bygget oven på Qwen3.8-27B, som kan køre på ét grafikkort. Sammen viser de to nyheder, hvor Qwen står lige nu: den store model er billig, men ikke i top, og de små modeller er blevet et fundament, som andre bygger videre på.
Qwen4-Max er nu til salg
Vi skrev i sidste uge om, hvornår Qwen 4 kommer, og at Qwen4-Max kun kunne lånes som preview. Nu kan den købes pr. token i API'et under navnet qwen4-max, og den findes også på OpenRouter. Den har omkring 2,4 billioner parametre, hvoraf 71 milliarder er aktive ad gangen, og et kontekstvindue på 1 million tokens. Vægtene er ikke frigivet, og Alibaba har ikke lovet, at de kommer. Det er et skifte, for vægtene til forgængeren Qwen3.8-Max blev lagt ud i august.
Prisen er sat ned i forhold til Qwen3.8-Max:
- Qwen4-Max koster cirka 10,50 kr pr. million input-tokens og 31,50 kr pr. million output-tokens.
- Claude Opus 5.5 koster cirka 28 kr for input og 140 kr for output.
- Gemte input-tokens (cache) koster cirka 50 øre for Qwen4-Max og 1,40 kr for Opus.
Artificial Analysis giver Qwen4-Max 43 point på sit samlede intelligensindeks mod 59 til Opus 5.5. En opgave i deres testsæt koster i gennemsnit omkring 23 kr med Qwen4-Max og 70 kr med Opus. Modellen er dog meget snakkesalig. Den skrev 127 millioner output-tokens i testen, omtrent dobbelt så mange som sammenlignelige modeller.
Qwen 4 mod Claude Opus 5.5 i tre agenttest
Alibabas egne målinger giver et blandet billede. Qwen4-Max taber til Opus på Terminal-Bench 4.0 med 48,5 mod 59,6 procent, men vinder på DeepSWE 1.1. The New Stack ville derfor se, hvordan modellerne klarer rigtigt agentarbejde, og byggede tre opgaver, der var svære nok til, at GPT-5 dumpede dem:
- En arbejdsgang på tværs af fire systemer i et opdigtet firma: sagsstyring, kodebase, chat og kalender. Modellen skulle sortere en kundefejl, finde den kodeændring, der skabte den, vælge den rigtige ansvarlige, regne frister ud og afvise to anmodninger, som firmaets regler forbyder.
- En fejlefterforskning, hvor tre samtidige nedbrud skulle forklares ud fra logs, målinger og ændringshistorik med vildspor, to servere med forkert ur og en misvisende alarm.
- En fejlrettelse i et regnskabsbibliotek med 11 plantede fejl. Seks af dem fanges ikke af nogen test, og tre af bibliotekets egne test er forkerte og skulle rapporteres, ikke rettes.
| Test | Claude Opus 5.5 | Qwen4-Max |
|---|---|---|
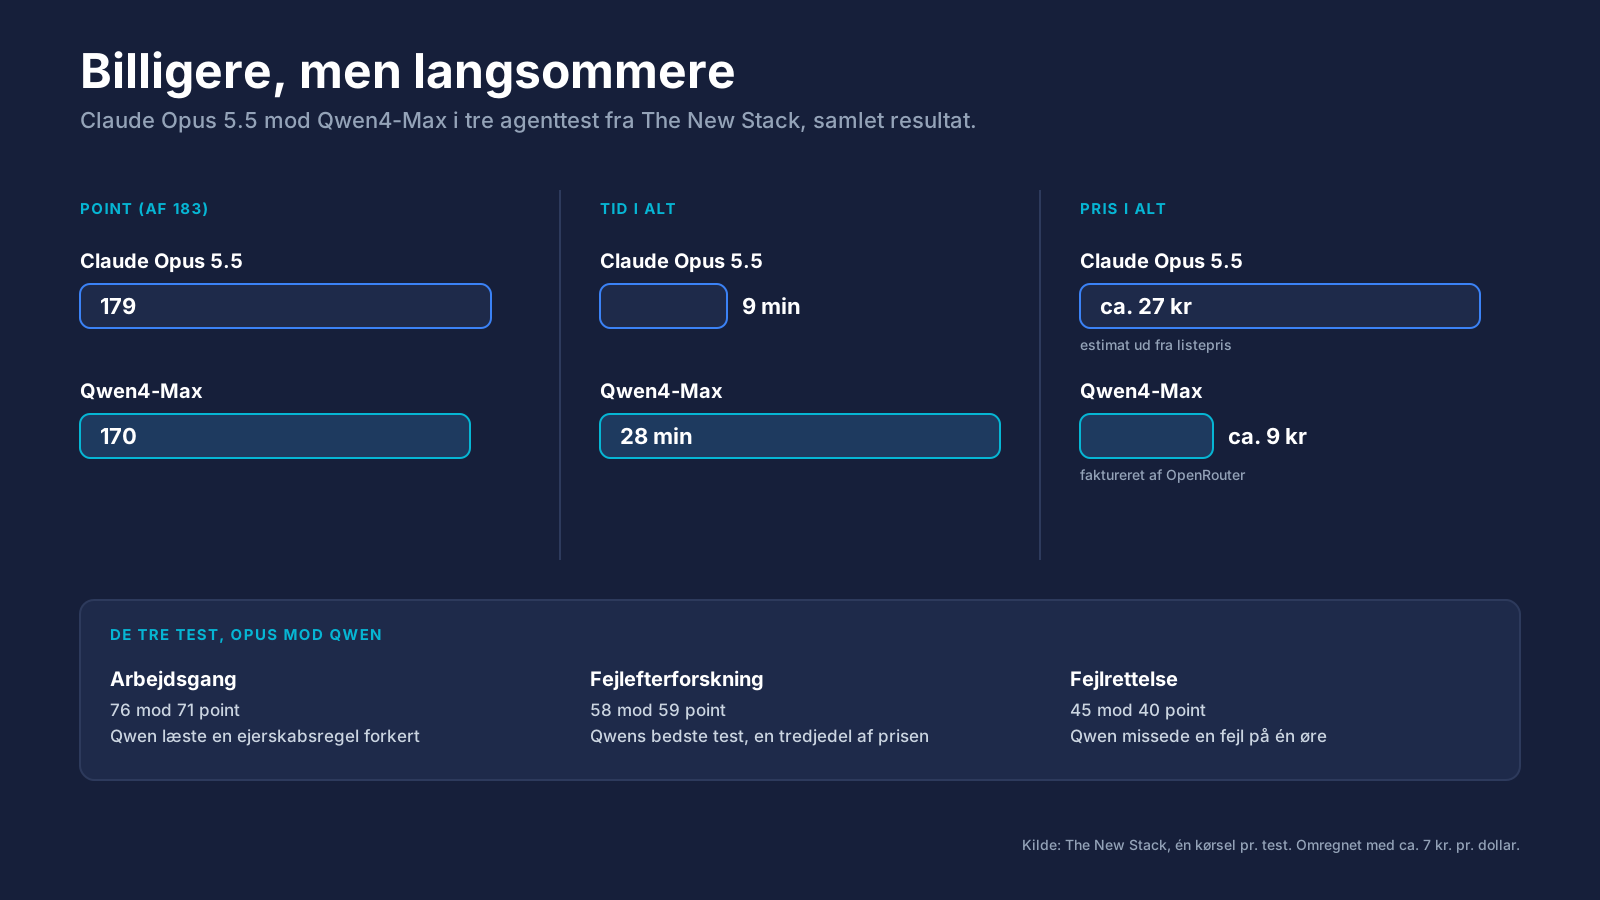
| Arbejdsgang (76 point) | 76 point, 4 min, ca. 15 kr | 71 point, 13 min, ca. 4,30 kr |
| Fejlefterforskning (60 point) | 58 point, under 4 min, ca. 10 kr | 59 point, 9,5 min, ca. 3,10 kr |
| Fejlrettelse (47 point) | 45 point, 1 min, ca. 2,70 kr | 40 point, 5 min, ca. 1,75 kr |
| I alt | 179 af 183, 9 min, ca. 27 kr | 170 af 183, 28 min, ca. 9 kr |
Opusprisen er et estimat ud fra tokenforbrug og listepris. Qwen-prisen er det, OpenRouter faktisk fakturerede. Hver test blev kun kørt én gang, så en forskel på et eller to point kan vende ved næste kørsel.
Hvor Qwen4-Max fejler
Fejlene er mere interessante end pointene. I arbejdsgangen kom alle fem tabte point fra samme misforståelse. Kodebasens ejerskabsfil siger, at når flere regler passer, vinder den sidste i filen. Qwen4-Max valgte hver gang den mest specifikke regel. Alt andet var rigtigt, også fristerne på tværs af tidszoner og begge afvisninger. Men i et rigtigt firma havde det sendt sager til det forkerte hold tre gange.
I fejlrettelsen fandt Opus alle 11 fejl og glemte kun at rapportere den tredje forkerte test. Qwen4-Max missede samme test, overså en fejl, hvor en betaling fordelt på flere fakturaer taber en øre, og efterlod en kladdefil i testmappen. Arbejdsmåden var også forskellig. Opus lavede sin første rettelse i fjerde runde og var færdig efter 12. Qwen4-Max læste filer i 15 runder, før den rørte koden, og brugte 30 runder i alt. Den ekstra læsning gav ikke en bedre score.
Fejlefterforskningen var Qwen4-Max' bedste resultat. Den scorede et point mere end Opus for omkring en tredjedel af prisen. Begge modeller gennemskuede vildsporene og de forkerte ure, og begge tilskrev en fejlkode til den forkerte tjeneste.
DaisyRose-27B bygger videre på Qwen
Hvor Qwen4-Max er lukket, er de små Qwen-modeller åbne under Apache 2.0, og det udnytter andre. RadixArk står bag SGLang, et af de mest brugte programmer til at køre sprogmodeller på servere, og firmaet rejste 100 millioner dollar, omkring 700 millioner kr, i maj. Nu har de udgivet deres første model, DaisyRose-27B.
Modellen er Qwen3.8-27B, efteroptrænet med forstærkningslæring (reinforcement learning) på lange agentopgaver. Det krævede kun 1.200 håndplukkede opgaver, 18 dage og 144 H200-grafikkort. Hver opgave blev designet, så den fremprovokerede en fejl, den oprindelige model laver, og hver opgave kunne tage op til halvanden time med over 100 værktøjskald. Opgaver, som modellen kunne snyde sig igennem uden at løse dem, blev rettet eller fjernet.
Resultatet ifølge RadixArk:
- Terminal-Bench 4.1 stiger fra 5,6 til 12,0 procent, altså mere end en fordobling på en af de sværeste agenttest.
- Modellen slår Qwen3.8-27B på alle syv test i RadixArks tabel, blandt andet DeepSWE 1.1 med 46,2 mod 42,2 og IFBench med 82,4 mod 79,5.
- Den kan erstatte Qwen3.8-27B direkte, fordi arkitektur, tokenizer og chatformat er uændret. Kontekstvinduet er 256.000 tokens.
Alle tal er RadixArks egne, og der findes endnu ingen uafhængige målinger. Til sammenligning scorer GPT-6 Luna 15,2 procent på Terminal-Bench 4.1, så DaisyRose er ikke i top. Men den er tæt på, og den er gratis at hente.
En model på ét grafikkort
Det praktiske ved DaisyRose-27B er størrelsen. Vægtene fylder omkring 52 GB i fuld præcision, 29 GB i FP8 og 23 GB i NVFP4, der kræver et nyere Nvidia-kort fra Blackwell-generationen. Modellen kan derfor køre på ét kort, fra et RTX 5090 eller en DGX Spark under skrivebordet til et H200 i et datacenter. Der findes allerede omkring 20 komprimerede udgaver til llama.cpp, Ollama og LM Studio. Det er samme udvikling, som gør det muligt at køre store open-weight-modeller lokalt uden at sende data ud af huset.
RadixArks egentlige budskab er dog ikke modellen, men opskriften. Firmaet bruger DaisyRose til at vise, at en virksomhed kan tage en åben model og træne den til sine egne opgaver uden et budget som OpenAI's. Deres træningsplatform Miles er open source, og de oplyser, at deres sandboxe kostede omkring 80 procent mindre end tilsvarende hos de store cloududbydere. For den, der bygger AI-agenter, der arbejder i jeres egne systemer, betyder det, at valget ikke længere kun står mellem at leje en stor model og selv bygge en fra bunden.
Hvilken Qwen-model passer til opgaven
Ingen af testene her gør Qwen4-Max til en erstatning for Opus. Den taber to af tre opgaver, bruger tre gange så lang tid, og dens fejl er af den slags, der er svære at opdage: en regel læst forkert og fulgt konsekvent hele vejen. The New Stack vil selv holde Opus 5.5 til kode og opgaver, hvor en forkert besked skaber problemer senere.
Til gengæld er Qwen4-Max et oplagt valg til efterforskning og analyse, hvor modellen skal grave i store mængder data og godt må bruge et par minutter ekstra. Her matchede den Opus til en tredjedel af prisen. Og hvis data ikke må forlade huset, er det ikke Qwen4-Max, men de små åbne Qwen-modeller og efteroptrænede varianter som DaisyRose, der er værd at holde øje med.
Kilder: The New Stack og RadixArk